Как не зависеть от одного поставщика ИИ: свой харнес и свои метрики
Почему от привязки к одному ИИ-поставщику защищает свой харнес, какие метрики нужны для переезда между моделями и когда выбрать LangSmith или Langfuse.
Я написал об этом статью для журнала «ИТ-инфраструктура»: «Меняем модель, а не систему: как избежать зависимости от одного ИИ-поставщика», 31 августа 2026 года. Она остаётся первоисточником: там подход разобран подробно, для ИТ-руководителей. Здесь - короткая выжимка из неё и то, что изменилось с тех пор: зачем строить свой харнес, какие метрики собирать и чем их отслеживать.
Материал для тех, у кого ИИ уже отвечает клиентам, разбирает заявки или ищет по базе знаний, и для тех, кто только собирается это внедрить.
Коротко о статье в журнале
Шесть мыслей оттуда - опора для всего остального.
- Зависимость нарастает незаметно. Сильную облачную модель берут под одну задачу, потом под соседние, и через несколько месяцев от неё зависят уже несколько процессов, хотя решения «строим всё вокруг этой модели» никто не принимал. Проверить себя можно одним вопросом: что придётся переписать, если поставщик завтра изменит цену, лимиты, правила работы с данными или поведение модели. Если в ответе промпт (инструкция для модели), разбор ответов, описания инструментов и часть интеграций, привязка уже вошла в сам процесс.
- Правила живут вне модели. Инструкции, память, инструменты, проверки и журнал выносят в отдельный слой, а модель подключают через адаптер - переходник под конкретную модель. Адаптер нужен, даже если у поставщиков похожий API (программный интерфейс): одинаковый способ вызова не означает одинакового поведения.
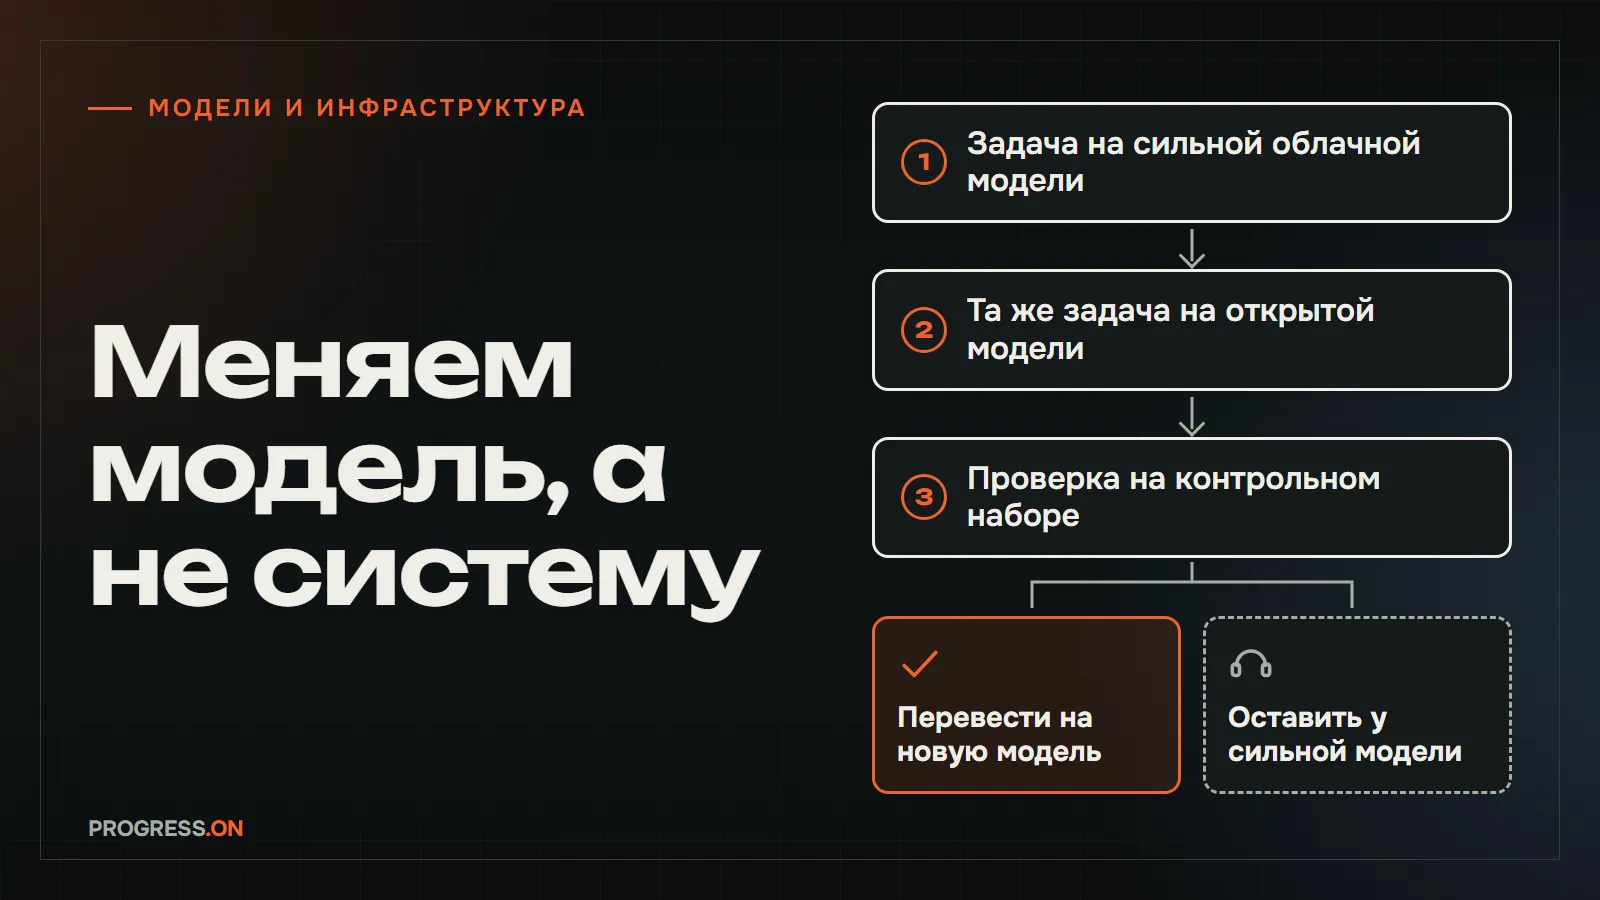
- Переносят по одному типу задач. Сначала задачу отрабатывают на сильной облачной модели, затем ту же задачу запускают на открытой через тот же контур, потом сверяют результат на контрольном наборе - подборке ваших реальных случаев. Если открытая модель не прошла пороги, задача остаётся у сильной модели, и это нормальный исход. Подробнее по шагам - ниже.
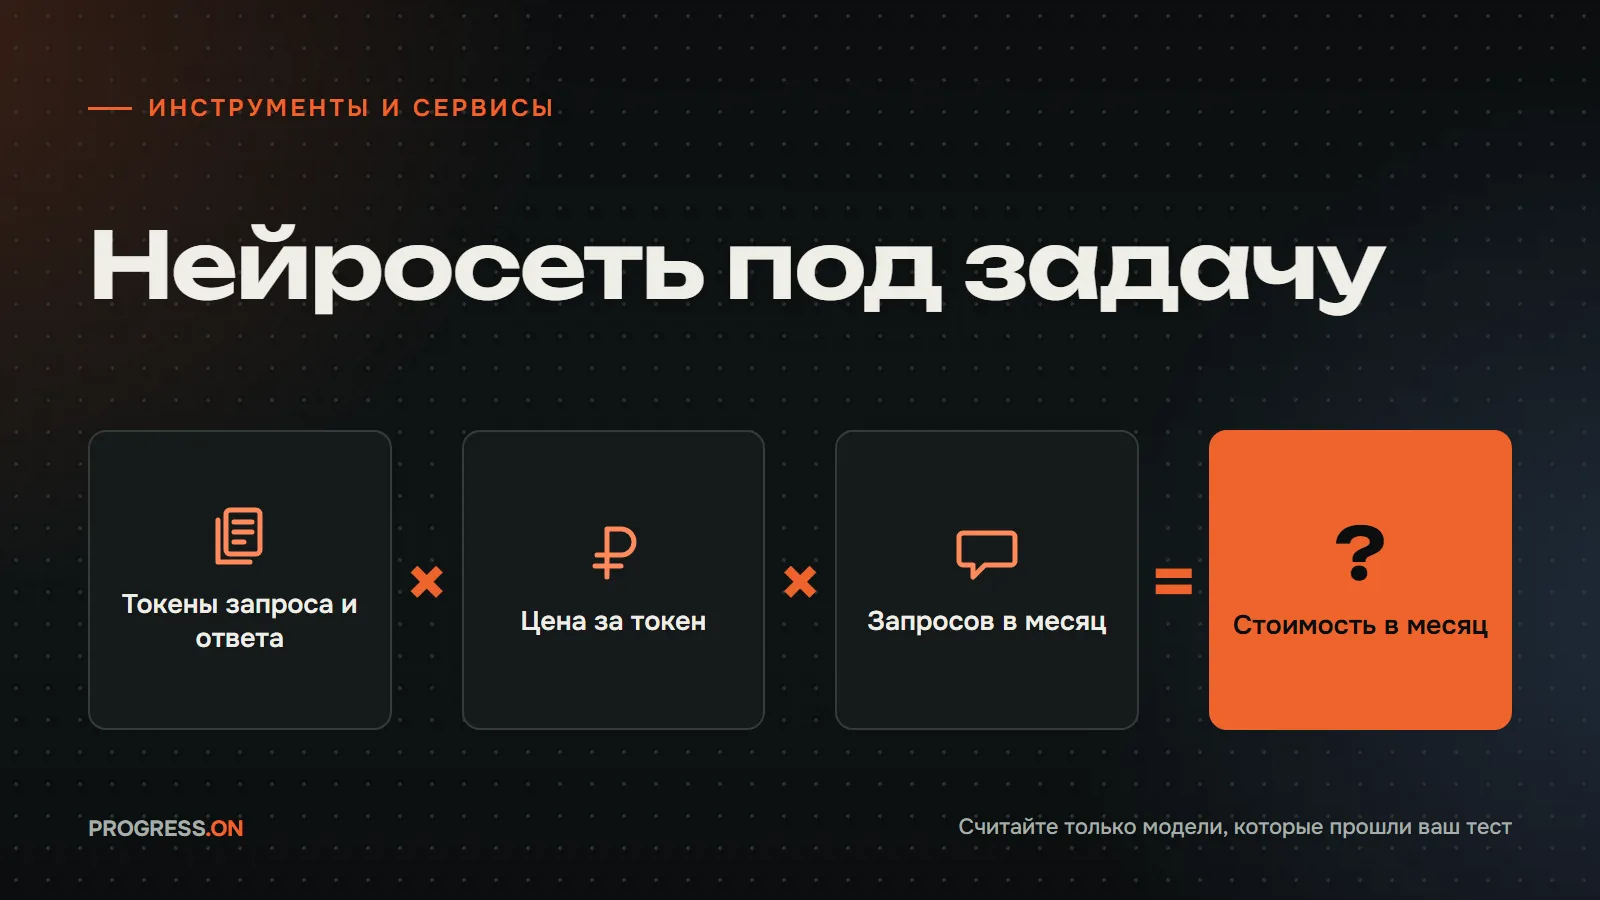
- Считают стоимость принятого результата, а не цену запроса. Своя модель при этом не всегда дешевле облака: при небольшой или нерегулярной нагрузке облачный API может выйти выгоднее.
- Осторожнее всего с действиями. Задачи, где модель совершает действия (платёж, изменение настроек, команда на удалённый объект), переносят последними. Публикации, изменения бюджета и денежные операции подтверждает человек: одного запрета в инструкции модели недостаточно.
- Свой сервер и закон - разные вопросы. Собственный сервер сам по себе не обеспечивает соответствие закону № 152-ФЗ «О персональных данных»: оценивают всю схему обработки, включая журналы и историю работы.
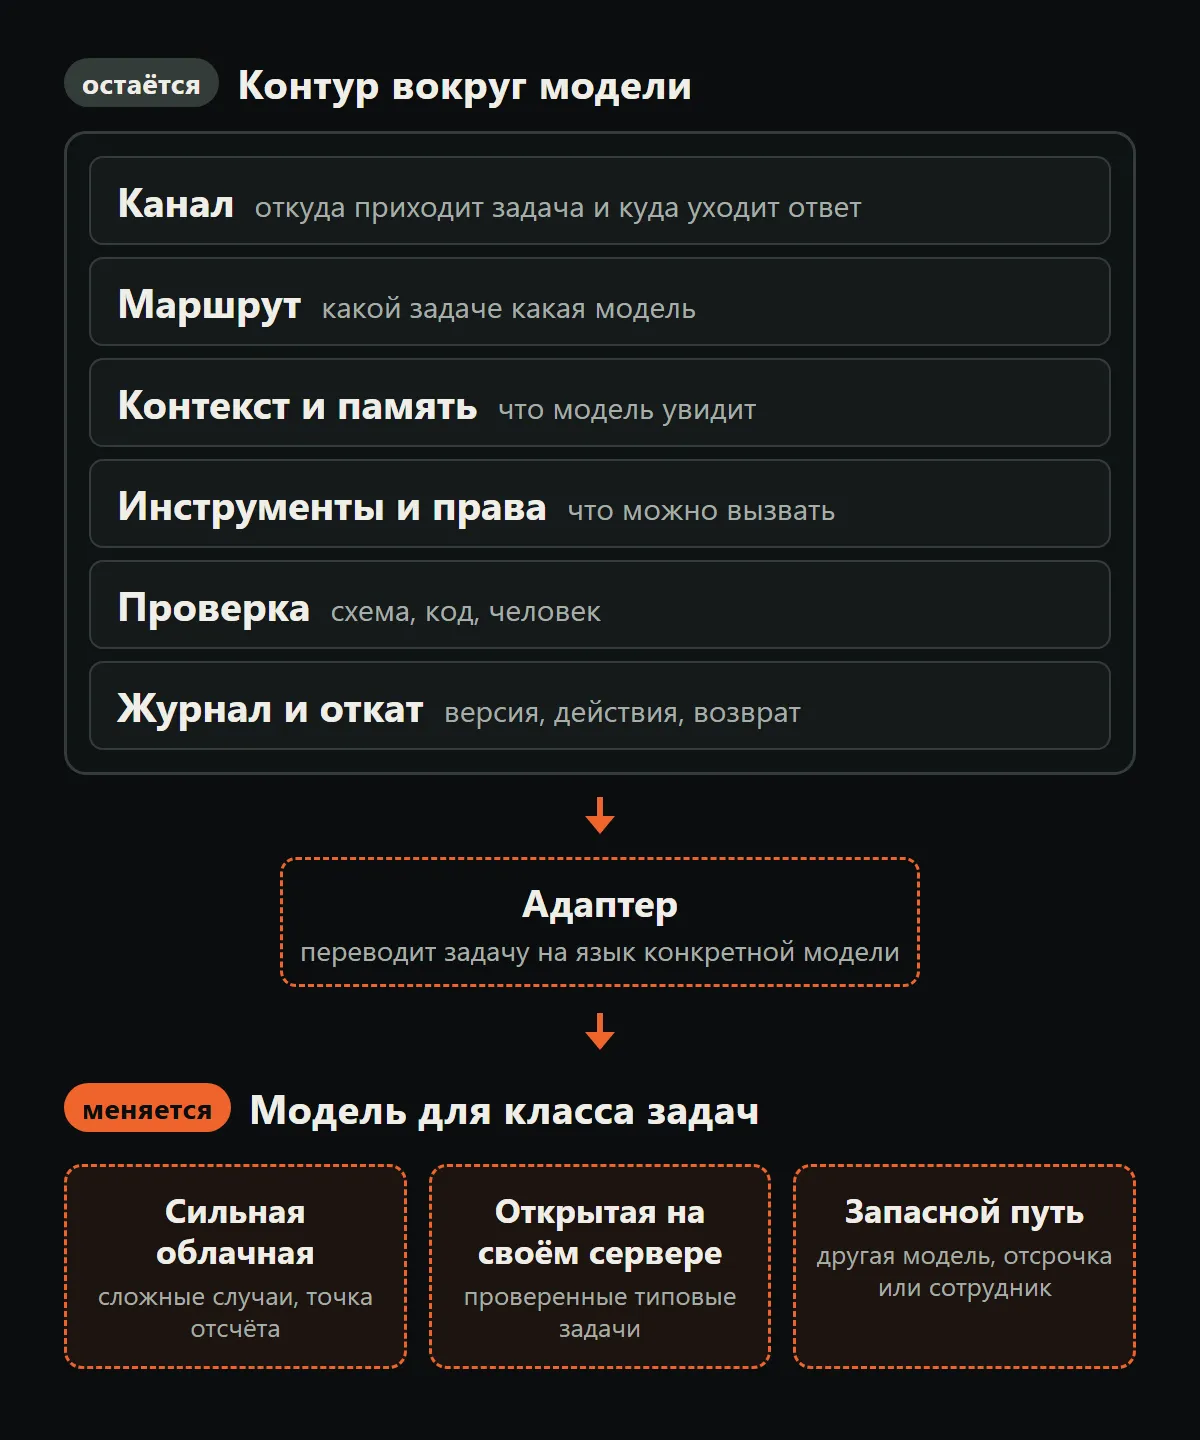
К концу августа 2026 года в моих процессах это выглядело так: крупные открытые модели вроде Qwen3.8, развёрнутые в собственной инфраструктуре, брали рассуждение и работу с инструментами, компактные - быстрые массовые операции, а внешние API оставались для сложных случаев и резерва. Один из контуров (его основа - Hermes Agent) раньше работал через внешние API, а к моменту статьи перешёл на открытые модели в собственной инфраструктуре. Модель поменяли, обвязка осталась прежней. В журнале я сформулировал это так:
Тогда вопрос «на какой модели мы работаем» перестает быть стратегическим и становится настройкой маршрута.
Примеры с инструментами для разработчиков, критерии успеха и случаи, когда переносить незачем, - в оригинале статьи.
Что изменилось с тех пор
«Харнес» стал модным словом
То, что в журнальной статье я в основном называл обвязкой, по-английски - harness, буквально «упряжь». Здесь я пишу «харнес». Харнес - всё, что окружает модель: правила, память, инструменты, проверки и журнал. Модель рассуждает, а харнес решает, что она увидит, что сможет вызвать и что будет с её ответом.
Харнесов сейчас будет очень много: термин стал модным, и это слово будут повторять везде. По сути харнесом является многое:
- Cursor, редактор кода с ИИ (официально в России не работает);
- Claude Code, агент для программирования от Anthropic (официально в России не работает);
- OpenClaw - открытый проект под лицензией MIT; по описанию в репозитории, состояние, память и ключи доступа хранятся на вашем оборудовании, а модели подключаются как сменные модули;
- Hermes Agent - открытый агент от Nous Research под лицензией MIT; на его основе сделан мой контур из журнальной статьи;
- ChatGPT от OpenAI (официально в России не работает).
Что зависимость от чужого инструмента - реальный риск, показал сентябрь. Через несколько дней после выхода журнальной статьи, 4 сентября 2026 года, Cursor перестал работать в России (по данным 3DNews со ссылкой на Forbes, без заявлений компании) и с тех пор официально в России не работает. Если правила проекта и привычный порядок работы жили только внутри такого инструмента, менять приходится уже весь инструмент.
Главный вывод: делайте свой харнес
Главный призыв этой статьи - делать свой харнес: с ним вы сможете переезжать на разные модели и сохранять качество.
Свой харнес необязательно писать с нуля. Важно, чтобы всё, кроме модели, принадлежало вам и переезжало вместе с вами:
- правила процесса, инструкции и память лежат в ваших файлах и базах, а не только в интерфейсе поставщика;
- модель подключена через адаптер, и у каждой модели он свой;
- маршрут «какой тип задач какой модели достаётся» записан в настройках харнеса;
- каждый запуск оставляет след: какая модель и версия, какая инструкция, что сделано и чем закончилось;
- есть контрольный набор и пороги, по которым решают о переезде.
Без своих метрик переезд вслепую
Чтобы переезжать без потери качества, нужны свои метрики и способ их отслеживать. Следить нужно за поведением агентов и качеством ответов, а по ним делать выводы. В таблице - что собирать для каждого типа задач:
| Что смотреть | Примеры метрик | Зачем при переезде |
|---|---|---|
| Поведение агента | какой инструмент выбран, все ли данные ему переданы, остановился ли агент с вопросом там, где без уточнения действовать нельзя, сколько понадобилось шагов и повторов | при смене модели поведение меняется прежде всего здесь |
| Качество ответов | доля ответов, принятых без правки; совпадение с решением специалиста; соблюдение формата; нет ли запрещённых действий | так видно, сохранилось ли качество в вашей задаче |
| Цена и скорость | токены и стоимость запуска вместе с инструментами, время ответа, стоимость принятого результата | цена запроса и цена результата - разные числа |
| Выводы | расхождения со старой моделью, возвраты задач к сильной модели, ручные вмешательства, сбои | по ним решают: переводить, подождать или вернуть |
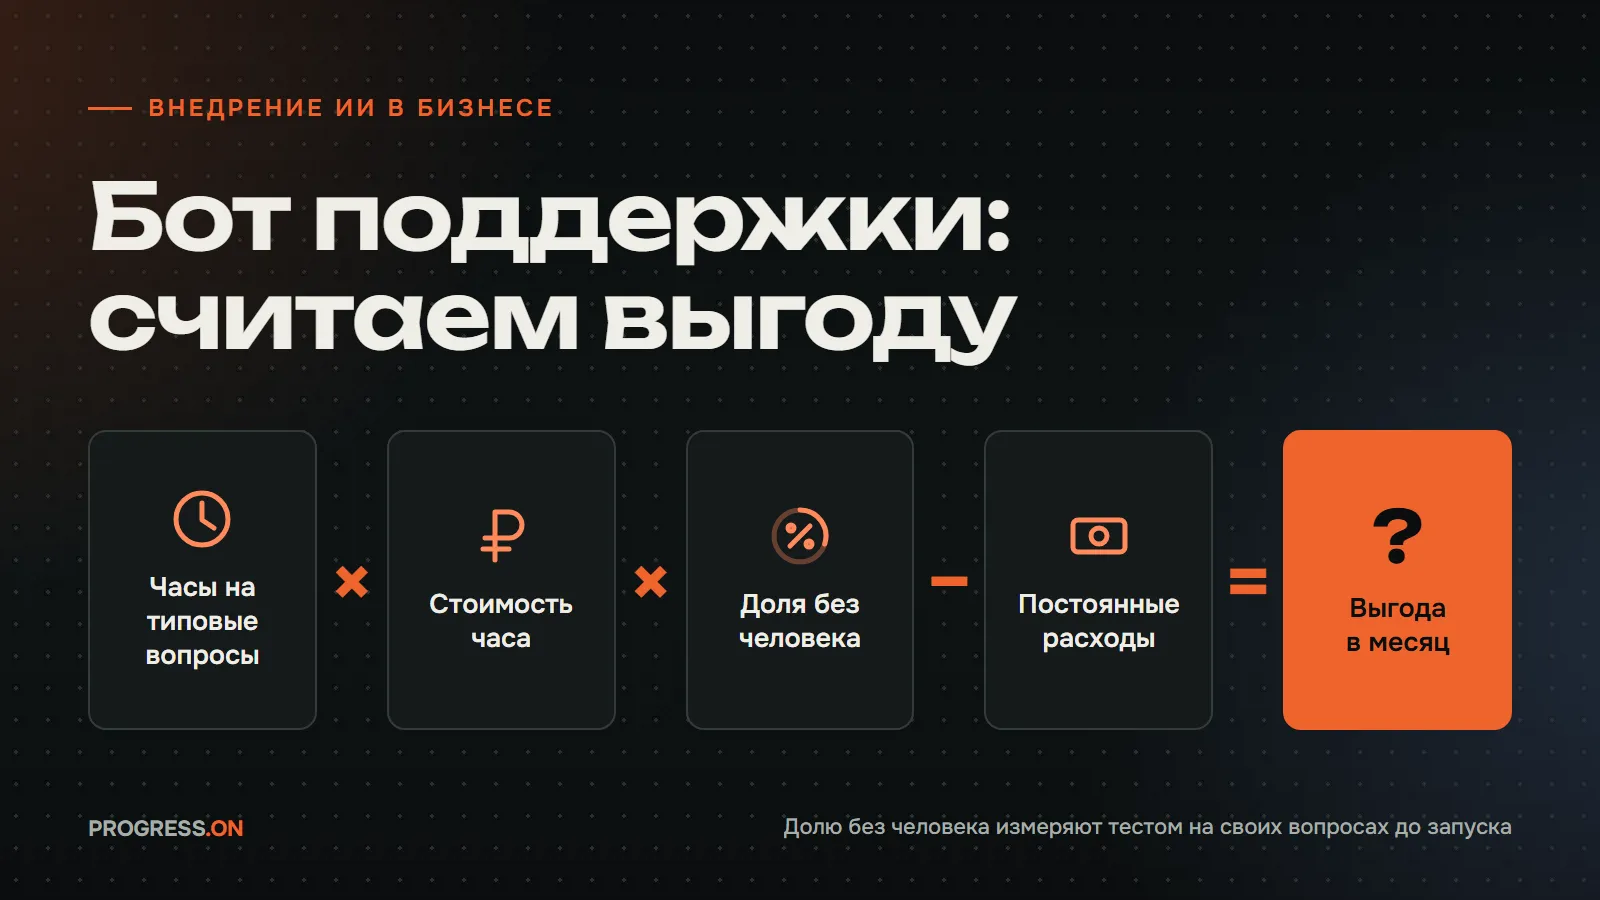
Почему важна именно стоимость принятого результата, покажет условный пример (цифры придуманы для наглядности, данных моих проектов здесь нет). 100 задач, каждая - один запрос. Модель А берёт 2 ₽ за запрос, и 5 ответов из 100 сотрудник переделывает, по 30 ₽ за каждый: 200 + 150 = 350 ₽, или 3,5 ₽ за выполненную задачу. Модель Б в четыре раза дешевле за запрос - 0,5 ₽, но переделывать приходится 30 ответов: 50 + 900 = 950 ₽, или 9,5 ₽ за задачу. Модель А дороже за запрос, но в пересчёте на выполненную задачу обходится почти втрое дешевле.
Записывайте метрики с метками: модель и её версия, версия инструкции, версия харнеса. Иначе через месяц уже трудно понять, отчего качество выросло или упало.
Как может выглядеть запись одного запуска - условный пример бота, который отвечает клиенту, где его заказ (иллюстрация, данных моих проектов здесь нет):
| Шаг запуска | Что сохраняется |
|---|---|
| Вход | вопрос клиента, тип задачи «статус заказа», метки: модель и её версия, инструкция v7, харнес v3 |
| Вызов инструмента | агент ищет заказ в CRM: какие параметры передал, что вернулось, сколько секунд это заняло |
| Ответ | текст ответа, токены, стоимость запуска |
| Проверка | номер заказа совпал, формат соблюдён, сотрудник принял ответ без правки |
Набрав такие записи по одному типу задач, вы увидите, где агент спотыкается. А когда подключите другую модель, те же записи покажут разницу.
LangSmith или Langfuse: когда что выбирать
Для сбора таких метрик я советую LangSmith и Langfuse. Оба ведут трассы - пошаговую запись одного запуска: вызовы модели и инструментов, промежуточные шаги и их результаты, - а ещё прогоняют датасеты (наборы ваших случаев) и сравнивают результаты экспериментов. Различаются они тем, для чего лучше подходят:
| LangSmith | Langfuse | |
|---|---|---|
| Для чего | глубокая отладка и оценки качества | независимый контур и собственный сервер |
| Что умеет (по документации, 20.10.2026) | трассы агентов; учёт токенов и стоимости по отдельным вызовам и по всему запуску, в том числе расходов на инструменты; датасеты, эксперименты и оценки | трассировка агентных цепочек, версии промптов, датасеты, оценки и сравнение экспериментов; использует OpenTelemetry, открытый стандарт сбора трасс |
| Когда выбирать | нужно понять, почему агент выбрал не тот инструмент, где потратил лишние токены, почему вспомогательный агент (субагент) не справился и как всё это меняется при замене модели | нужна независимость от конкретного фреймворка (библиотеки для сборки агентов), перенос системы на свой сервер и контроль над тем, где лежат данные |
| Ограничение | польза максимальна, когда ваш код отправляет все нужные события и метаданные; это не автоматический анализ любой программы. Естественнее всего встраивается в LangChain и LangGraph | харнес придётся правильно настроить, чтобы он отправлял события. Сам Langfuse не запускает агентов и не заменяет их оркестрацию (управление запуском) |
| Свой сервер | только как дополнение к тарифу Enterprise | можно поставить самостоятельно: основные функции под лицензией MIT без ограничений использования, отдельные корпоративные модули (SCIM, журнал аудита, политики хранения данных) - по платной лицензии |
| Работа в России | официальных сведений нет: перечня стран у LangChain нет, в условиях (ред. 02.06.2026) - общий пункт о соблюдении экспортных и санкционных законов США | об облачной версии официальных сведений нет, в условиях - пункт об экспортных правилах и санкциях США; открытый код скачивается из публичного репозитория и разворачивается у вас |
Если коротко: агент построен с помощью LangChain или LangGraph и нужна глубокая отладка - присмотритесь к LangSmith, но сначала выясните, может ли ваша компания им пользоваться и где окажутся данные. Нужен свой сервер и независимость от фреймворка - Langfuse.
В обоих случаях инструмент видит только то, что ему отправляет ваш харнес. Поэтому метрики из прошлого раздела сначала нужно заложить в сам харнес: какие события отправлять и с какими метками.
Помните и про данные: в трассу попадают тексты запросов и ответов, а с ними и данные клиентов, если они там есть. В журнальной статье я писал, что правила хранения и доступа охватывают и историю работы, а трассы - её часть. По документации, и LangSmith, и Langfuse умеют скрывать чувствительные поля до отправки, а Langfuse, развёрнутый у вас, оставляет трассы в вашей инфраструктуре. Допустим ли тот или иной вариант для ваших данных, решают по всей схеме обработки: одного выбора инструмента для этого мало.
Одни правила - разное поведение моделей
Разные модели могут по-своему вести себя с одними и теми же правилами, и это нужно учитывать. Ещё в журнальной статье я писал, что даже новая версия прежней модели может иначе понять ту же инструкцию, а при смене модели первым меняется поведение с инструментами: как модель их вызывает, все ли данные передаёт, готова ли действовать без уточнения.
Практические выводы (это рекомендации, описания моих проектов здесь нет):
- общие правила процесса держите в харнесе, а поправки под конкретную модель - в её адаптере, чтобы процесс оставался общим для всех моделей;
- запускайте старую и новую модель с одними и теми же правилами и одним контрольным набором и сравнивайте их трассы рядом;
- обновление той же модели - тоже переезд: прогоняйте набор заново.
Как перевести один тип задач на другую модель
Порядок из журнальной статьи, дополненный метриками:
- Выберите узкий тип задач. «Работа с обращениями» - слишком широко. «Определить тему обращения по справочнику» - подходит.
- Запишите пороги. Какие метрики из таблицы выше вы смотрите и какие значения считаете успехом.
- Соберите контрольный набор. Возьмите реальные случаи, включая редкие и те, где уже были ошибки. Персональные и конфиденциальные данные обезличьте или работайте с ними там, где это разрешено. Присвойте набору версию.
- Снимите эталон на сильной облачной модели. Прогоните набор через ваш харнес и сохраните результаты как эксперимент.
- Запустите ту же задачу на открытой модели, если лицензия этой версии и требования к оборудованию подходят для вашего использования. Харнес прежний, меняется только адаптер. Сравните оба эксперимента на контрольном наборе по метрикам.
- Проверьте в теневом режиме. Новая модель получает копии настоящих задач, но её ответы видите только вы. Разберите расхождения, затем отдайте ей небольшую долю запросов этого типа.
- Решите по порогам. Модель прошла пороги - переводите на неё этот тип задач и держите путь назад. Не прошла - тип задач остаётся у сильной модели. Сложные и новые случаи в любом исходе оставьте сильной модели.
Вывод действует только для того типа задач, который вы проверили. Задачи, где модель совершает действия, переводите последними, а значимые операции пусть подтверждает человек.
Ремарка: тест харнеса DeepSeek
Новые харнесы появляются быстро. Я тестировал DeepSeek Harness с официальной страницы: проверял сам харнес со своей локальной моделью Qwen3.8. По официальной странице, это предварительная версия для всех стран, с открытым кодом под лицензией MIT; возможности в нём добавляются плагинами, а в режиме Creator плагины можно создавать через чат.
Идея интересная, но пока очень сырая. Встроенный режим Creator после моих манипуляций каждый раз ломал плагинами сам себя. Хотя внутри Creator работала модель по умолчанию - DeepSeek-V4.1-Flash. Я всегда говорил и говорю: дайте методике устояться.
Это ремарка по личному тесту, без указания версии приложения, а обновления выходят часто. Например, по новостям API DeepSeek, 17 октября 2026 года вышла обновлённая сборка DeepSeek-V4.1-Flash-1017. Отсюда совет (это вывод из ремарки; отдельного теста под этот совет нет): новый харнес пробуйте на копии задачи, а рабочий процесс переносите, когда инструмент перестанет ломаться в ваших сценариях.
С чего начать
- Составьте список процессов с ИИ: какие модели и сервисы работают, какие данные туда уходят, чем грозит ошибка.
- Задайте себе вопрос из журнальной статьи: что придётся переписать, если поставщик завтра изменит условия.
- Вынесите правила, память, инструменты и проверки одного процесса в свой харнес, модель подключите через адаптер.
- Запишите метрики для одного типа задач и подключите их сбор: собственный Langfuse или LangSmith, если его использование допустимо для вашей компании.
- Проведите модель-кандидата по шагам выше, а о расширении решайте по стоимости принятого результата и качеству.
Независимость - не самоцель: сложные случаи вполне могут оставаться у сильной модели. Важно, чтобы решение, кому какую работу отдавать, принимали вы сами и по своим метрикам.
Частые вопросы
Что такое харнес простыми словами?
Всё, что окружает модель: правила, память, инструменты, проверки и журнал. Модель рассуждает, а харнес решает, что она увидит, что сможет вызвать и что будет с её ответом. В журнальной статье я в основном называл это обвязкой.
LangSmith или Langfuse - что выбрать?
LangSmith - для глубокой отладки и оценок качества, особенно для агентов из LangChain или LangGraph. Официальных сведений о его работе в России нет, а собственная установка возможна только как дополнение к тарифу Enterprise. Langfuse - если нужны свой сервер и независимость от фреймворка: основные функции открыты под лицензией MIT; об облачной версии Langfuse официальных сведений о работе в России тоже нет. Оба показывают только то, что им отправляет ваш харнес.
Можно ли просто настроить автоматическое переключение на резервную модель при сбое?
Можно, но без учёта типа задачи такое переключение может незаметно снизить качество. Надёжнее заранее решить для каждого типа задач, что будет при сбое: задачу возьмёт другая проверенная модель, сотрудник или её отложат.
Обязательно ли ставить модель на свой сервер?
Нет. Свой сервер оправдан при ровной большой нагрузке или когда этого требуют правила работы с данными, и то после расчёта. При небольшой или нерегулярной нагрузке облачный API может обойтись дешевле. Независимость даёт харнес, через который модель можно заменить, а где стоит сама модель - вопрос второй.
Источники
Факты в статье проверены .
- Антон Холодков. Меняем модель, а не систему: как избежать зависимости от одного ИИ-поставщика. «ИТ-инфраструктура», 31.08.2026проверено
- Пост в канале @progress_on №108: анонс статьи в «ИТ-инфраструктуре»проверено
- 3DNews: Российским вайб-кодерам заблокировали доступ к сервису Cursor, 10.09.2026 (Cursor официально в России не работает)проверено
- Anthropic: страны и регионы, где доступен Claude (России в списке нет, Claude и Claude Code официально в России не работают)проверено
- OpenAI: страны и территории, где доступен API (России в списке нет, OpenAI официально в России не работает)проверено
- OpenAI: страны, где доступен ChatGPT (России в списке нет, ChatGPT официально в России не работает)проверено
- Документация Claude Code: обзор продукта (о доступности в России - список стран Anthropic выше; Claude Code официально в России не работает)проверено
- OpenClaw: репозиторий проекта на GitHub (лицензия MIT)проверено
- Документация LangSmith: наблюдаемость и трассыпроверено
- Документация LangSmith: учёт стоимостипроверено
- Документация LangSmith: оценка качества, датасеты и экспериментыпроверено
- Документация LangSmith: развёртывание на своём серверепроверено
- Документация LangSmith: как не отправлять чувствительные данные в трассыпроверено
- LangChain: условия использования LangSmith (ред. 02.06.2026)проверено
- Langfuse: открытый код и лицензиипроверено
- Langfuse: развёртывание на своём серверепроверено
- Langfuse: оценка качества, датасеты и экспериментыпроверено
- Langfuse: управление промптамипроверено
- Langfuse: интеграции и OpenTelemetryпроверено
- Langfuse: маскирование данных в трассахпроверено
- Langfuse: репозиторий и лицензия на GitHubпроверено
- ClickHouse General Terms and Conditions (действуют для Langfuse Cloud, п. 11.5 об экспортных правилах и санкциях США)проверено
- DeepSeek Harness: официальная страницапроверено
- DeepSeek API: выпуск DeepSeek-V4.1-Flash и журнал обновленийпроверено
- LangChain и LangGraph: открытые библиотеки на GitHub (лицензия MIT)проверено
- Hermes Agent: репозиторий Nous Research на GitHub (лицензия MIT)проверено
- Hugging Face: Qwen3.8-27Bпроверено
- Федеральный закон от 27.07.2006 № 152-ФЗ «О персональных данных»проверено