Чат-бот поддержки на базе знаний: где бизнес теряет деньги и как посчитать окупаемость
Где поддержка теряет деньги, как посчитать выгоду бота на своих числах, что отдать ему первым, как проверить ответы до запуска и когда бот вредит.
Статья для владельца бизнеса или руководителя поддержки, у которого сотрудники каждый день отвечают на одно и то же. В основе - мой пост в канале от июня 2025 года. Здесь к нему добавлены условный пример расчёта, порядок проверки бота до запуска и случаи, когда бот вредит. Сведения о сервисах и законах проверены 12 октября 2026 года.
Где поддержка теряет деньги
Два места видны сразу, ещё два - гипотезы, которые стоит проверить на своих обращениях.
Повторяющиеся вопросы. «Сколько стоит доставка», «как вернуть товар», «где мой заказ» - ответ на такие вопросы записан в одном документе, а пишут его каждый раз руками. Время сотрудника на эти ответы - прямые деньги: его легко перевести в рубли через ставку специалиста.
Обращения вне рабочего времени. Клиент написал вечером или в выходной, ответ получил утром. Гипотеза: часть таких клиентов к утру уже купила у другого. Проверить её можно так: выгрузите обращения за месяц, отметьте пришедшие вне графика и сравните, какая доля из них стала заказом, с той же долей у дневных.
Долгое ожидание в рабочее время. В часы пик очередь растёт, и простой вопрос стоит в той же очереди, что и сложный. Это тоже гипотеза. Проверить её помогут время первого ответа из вашей системы обращений и доля диалогов, после которых клиент пропал.
Медленный старт новичков. Новый сотрудник неделями спрашивает опытных коллег, где что лежит, и ошибается в ответах клиентам. Здесь есть исследование. Эрик Бриньолфссон, Даниэль Ли и Линдси Рэймонд изучили данные 5179 операторов поддержки в компании, где помощника на генеративном ИИ вводили поэтапно (NBER, рабочая версия w31161, 2023). По этой версии работы, с помощником операторы в среднем стали закрывать на 14% больше обращений в час, новички и менее квалифицированные - на 34%, у опытных и самых квалифицированных эффект был минимальным. Важные оговорки: это помощник, который предлагал оператору варианты ответа, а оператор сам решал, использовать ли их; данные - одной компании-разработчика программ из списка Fortune 500, помощника внедряли в 2020-2021 годах (обзор NBER). Ожидать у себя таких же процентов не стоит, но направление понятно: подсказки ИИ-помощника сильнее всего помогали тем, кто пришёл недавно.
Исследование измеряло подсказки оператору во время разговора с клиентом, а не бота для сотрудников. Но для новичков подходит и тот же бот, только обращённый внутрь компании. Он отвечает сотрудникам о регламентах, инструкциях к программам и кадровых вопросах по внутренней базе знаний, и руководителю не приходится объяснять одно и то же каждому новичку.
Как бот отвечает по базе знаний
Обычная языковая модель отвечает тем, что запомнила при обучении. Ваших цен, условий возврата и регламентов она не знает. В документации библиотеки LlamaIndex это сказано прямо:
Большие языковые модели обучены на огромных объёмах данных, но не на ваших данных.
Поэтому бота поддержки строят на схеме RAG (Retrieval Augmented Generation, «генерация с опорой на найденное»). Метод описан в научной статье Патрика Льюиса и соавторов 2020 года (arXiv). Работает так:
- Ваши документы - FAQ (ответы на частые вопросы), инструкции, каталог, правила доставки и возврата - заранее нарезают на фрагменты и складывают в поисковый индекс.
- На вопрос клиента система находит в индексе несколько самых подходящих фрагментов.
- Модель получает вопрос вместе с этими фрагментами и составляет ответ из них.
Из этого следуют два практических вывода. Первый: чтобы бот узнал новые условия, достаточно обновить документ в базе. Авторы RAG показали это в эксперименте с заменой индекса: знания такой системы обновляются заменой базы, а моделям без внешней базы для этого нужно дополнительное обучение (arXiv, раздел Index hot-swapping). Второй: бот отвечает хорошо ровно настолько, насколько хороша база. Если правила возврата в документах устарели или противоречат друг другу, бот уверенно повторит ошибку.
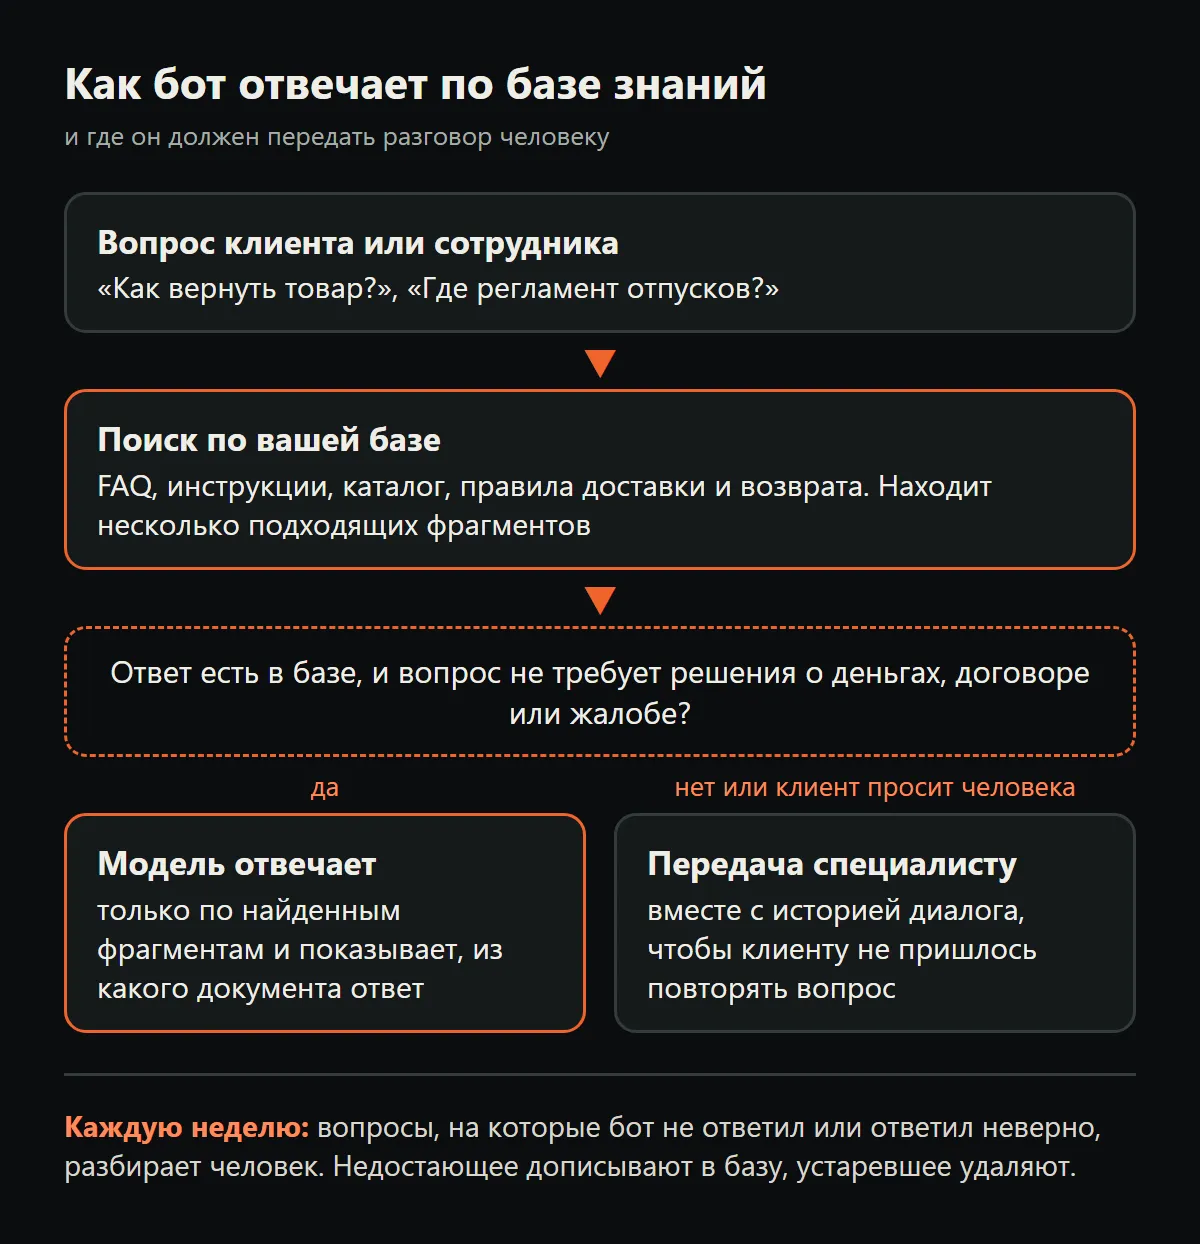
Верный ответ не гарантирован даже при хорошей базе: поиск может найти не тот фрагмент, а модель - додумать то, чего в документе нет. Поэтому в схеме две защиты: бот показывает, из какого документа взят ответ, и передаёт разговор человеку, если ответа в базе нет или вопрос касается денег, договора или жалобы.
Как посчитать, окупится ли бот
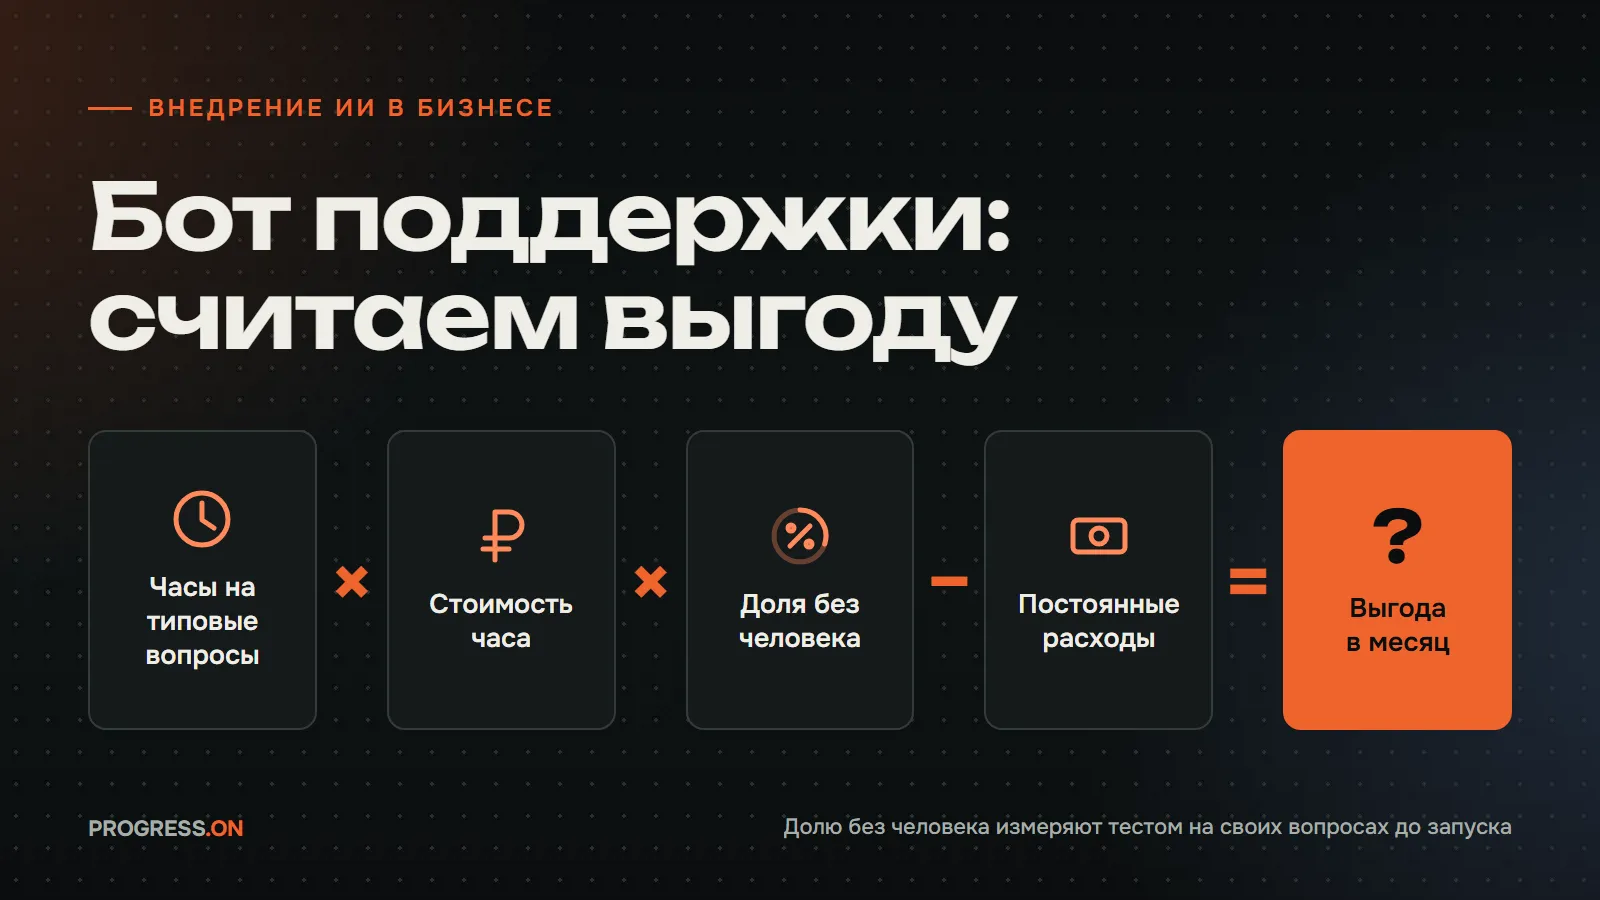
В посте я предлагал быстрый расчёт: посмотрите, как часто повторяются типовые вопросы, сколько времени специалист на них тратит, и умножьте это время на его ставку. Это хорошая отправная точка, но она даёт верхнюю границу - экономию при условии, что бот закроет все такие вопросы сам и ничего не будет стоить. Для решения нужны ещё две поправки.
Доля вопросов, которую бот закрывает без человека. Её нельзя взять из рекламы, только измерить (как - в разделе о проверке). По моей оценке в посте 2025 года, бот может отвечать на 80% стандартных вопросов, но у вас доля зависит от того, насколько полна база и насколько вопросы действительно типовые.
Постоянные расходы. Модель и сервис, где работает бот, плюс время сотрудника, который обновляет базу и разбирает ошибки. Без этого человека база устаревает, и бот начинает ошибаться.
Формула:
Часы в месяц = типовые обращения в месяц × минуты на одно / 60
Верхняя граница = часы в месяц × стоимость часа специалиста
Выгода в месяц = верхняя граница × доля без человека − постоянные расходы
Окупаемость запуска, месяцев = разовые расходы / выгода в месяцУсловный пример
Все числа ниже выдуманы для иллюстрации, это не данные клиента и не средние рыночные значения. Подставьте свои.
- 1200 типовых обращений в месяц, 5 минут специалиста на одно - 100 часов в месяц;
- стоимость часа специалиста с налогами - 600 ₽, верхняя граница - 60 000 ₽ в месяц;
- постоянные расходы: модель и сервис - 15 000 ₽ в месяц, плюс 8 часов сотрудника, который ведёт базу (4800 ₽), итого 19 800 ₽;
- запуск (разовые расходы) - 100 000 ₽.
| Доля вопросов, закрытых без человека | Сэкономлено в месяц | Выгода за вычетом расходов | Окупаемость запуска |
|---|---|---|---|
| 20% | 12 000 ₽ | −7800 ₽ | не окупается |
| 40% | 24 000 ₽ | 4200 ₽ | около 24 месяцев |
| 60% | 36 000 ₽ | 16 200 ₽ | около 6 месяцев |
Из примера видно главное: при том же потоке обращений результат решает доля, которую бот закрывает сам. При 20% постоянные расходы съедают всю экономию, а чем меньше поток обращений, тем большая доля нужна, чтобы бот окупился. Поэтому сначала тест и измерение доли, потом решение о покупке.
Две оговорки к расчёту. Сэкономленные часы превращаются в деньги, только если освободившееся время занято другими задачами или вам не приходится нанимать ещё одного человека при росте обращений. А выгоду от ответов ночью и в часы пик считайте отдельно, после проверки гипотез из первого раздела, и прибавляйте к экономии времени только тогда, когда увидели её в своих данных.
О том, как сравнить модели между собой и посчитать цену одного запроса в рублях, - отдельная статья: как выбрать нейросеть под задачу и не переплатить.
Что отдать боту первым
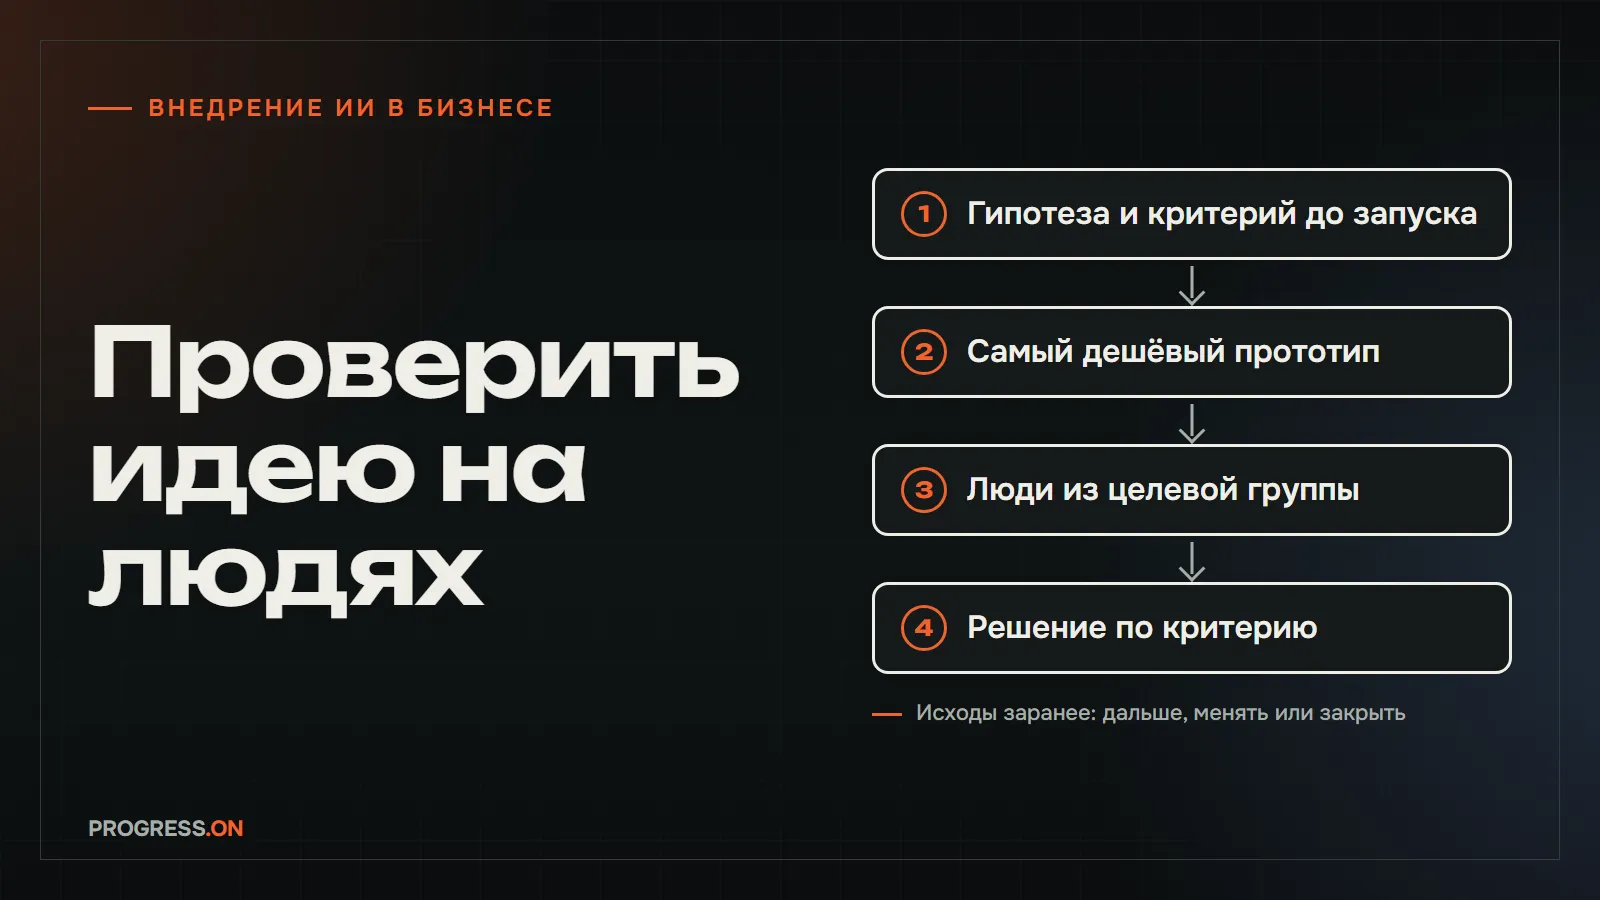
Автоматизировать сразу все 100% я не советую: это нереально. По моей оценке в том же посте, достаточно начать с 10-20% рутинных задач, и это уже даст результат. Не путайте эту цифру с долей из расчёта выше: 10-20% - объём первого запуска, а доля в таблице - часть вопросов, которую бот закрыл сам. Результат пилота - измеренная доля и ответ на вопрос, стоит ли расширять бота. Если бот сам закрывает небольшую долю вопросов, он окупается, только когда постоянные расходы малы по сравнению с потоком обращений.
Выбирайте вопросы с четырьмя признаками: их задают часто, ответ уже записан в документах, ошибка бота стоит недорого и исправляется следующим сообщением, а для ответа не нужно принимать решение за компанию.
| Задача | Подходит для начала? | Почему |
|---|---|---|
| Доставка, оплата, сроки, график работы | да | частые вопросы, ответ есть в правилах |
| Подбор товара из каталога, наличие, характеристики | да, если каталог актуален | бот берёт ответ из каталога; устаревший каталог - устаревшие ответы |
| Первые шаги диагностики из инструкции | да, с передачей специалисту | бот ведёт клиента шагами из инструкции, сложное отдаёт человеку |
| Вопросы сотрудников о регламентах, программах, договорах и спецификациях | да | ошибку замечает свой сотрудник, а не клиент |
| Справки для менеджеров о продуктах, ценах, удачных примерах | да, если цены и остатки берутся из учётной системы | иначе бот назовёт старую цену |
| Запись на встречу, квалификация заявки | после первых шагов | нужна связка с календарём и CRM - системой учёта клиентов |
| Возврат денег, компенсации, изменение договора | нет | решение затрагивает права клиента, его принимает человек |
| Жалобы и конфликтные обращения | нет | клиенту нужен человек, бот только раздражает |
Меня до сих пор удивляет, сколько компаний обходятся без простейшего бота для частых вопросов, не делят заявки на типы и не связывают переписку с CRM. Это базовые вещи. Для бота они начинаются с порядка в собственных документах, а выбор модели вторичен: если ответа нет в базе, его не найдёт и бот.
Когда бот вредит
Бот уверенно отвечает неправду
Пример - решение трибунала по гражданским спорам Британской Колумбии (Канада) по делу Moffatt v. Air Canada от 14 февраля 2024 года. Чат-бот на сайте авиакомпании сказал пассажиру, что скидку на перелёт в связи со смертью родственника можно оформить задним числом, в течение 90 дней. На странице правил, ссылку на которую дал тот же бот, было написано обратное. Компания доказывала, что за слова бота ответственности нет. Трибунал отверг этот довод:
Для Air Canada должно быть очевидно, что она отвечает за всю информацию на своём сайте. Неважно, исходит ли информация со статичной страницы или от чат-бота.
Авиакомпанию обязали возместить разницу в цене билетов - 650,88 канадского доллара, а вместе с процентами и сборами - 812,02 канадского доллара (решение трибунала). Это дело в Канаде, российский суд может рассуждать иначе. Но вывод для любой компании один: клиент воспринимает ответ бота как ответ компании. Отсюда правила: бот отвечает только из базы, показывает источник, а при противоречии в документах честно говорит «уточню у специалиста».
Бот обрабатывает персональные данные
Имя, телефон, номер заказа и адрес в переписке - это персональные данные, и их обработка через бота подпадает под требования 152-ФЗ «О персональных данных». Три статьи стоит обсудить с юристом до запуска:
- статья 18, часть 5: при сборе персональных данных граждан России запись, хранение и другие действия с ними с использованием баз данных за пределами России не допускаются, кроме случаев из пунктов 2, 3, 4 и 8 части 1 статьи 6 (текст статьи);
- статья 12, часть 3: передача персональных данных иностранной компании на территории другого государства - это трансграничная передача (так её определяет статья 3). Если переписка с такими данными уходит в зарубежный сервис модели, до начала передачи оператор обязан уведомить Роскомнадзор. Ведомство рассматривает уведомление десять рабочих дней и может запретить или ограничить передачу; до конца этого срока передавать данные в страны, которых нет в перечне стран с адекватной защитой, нельзя (текст статьи 12, портал Роскомнадзора);
- статья 16: решения, которые порождают юридические последствия для человека или иначе затрагивают его права, нельзя принимать на основании исключительно автоматизированной обработки его персональных данных, кроме случаев письменного согласия или прямо предусмотренных законом (текст статьи). Практический вывод: отказ в возврате или изменение условий решает человек, бот только передаёт ему обращение.
У клиента нет выхода на человека
Бот, который на любой сложный вопрос повторяет «уточните запрос», может быть хуже, чем отсутствие бота: клиент тратит время и уходит злым. Кнопка «связаться со специалистом» должна быть видна всегда, а специалист должен получать всю историю диалога, чтобы клиенту не пришлось пересказывать вопрос заново.
Как проверить ответы до запуска
- Соберите несколько десятков реальных вопросов из переписки и звонков за последние месяцы. Берите формулировки клиентов как есть, с опечатками и без контекста, но уберите из них имена, телефоны, адреса и номера заказов: вопросы пойдут через бота и сервис модели.
- Для каждого вопроса запишите правильный ответ и документ, где он находится. Это ваш эталон.
- Добавьте вопросы, ответа на которые в базе нет, и вопросы о возврате денег и жалобы. На них бот должен честно сказать, что передаёт вопрос специалисту.
- Прогоните все вопросы через бота и отметьте каждый ответ: верно; верно, но неполно; неверно; правильно передал человеку. Неверные ответы на вопросы о деньгах и условиях договора недопустимы: каждый такой случай разберите и исправьте базу или правила бота.
- Посчитайте долю вопросов, где бот ответил верно и сам, только по вопросам из первого шага. Контрольные вопросы из третьего шага считайте отдельно: они проверяют передачу человеку. Если знаете, как часто задают каждый вопрос, учитывайте это: частый вопрос весит больше редкого. Получится доля для расчёта окупаемости, а не цифра из рекламы.
- Сначала запустите бота для сотрудников или для части обращений, а неотвеченные вопросы и неверные ответы разбирайте каждую неделю: дописывайте недостающее в базу, удаляйте устаревшее.
Из чего собрать бота
В посте я перечислял четыре пути. Для России к ним нужна поправка: часть названных там сервисов здесь официально не работает, поэтому ниже к зарубежным моделям добавлены модели российских поставщиков.
Готовые конструкторы без программирования. Сервисы, в которых ассистента собирают из своих данных без глубоких знаний программирования; в посте я писал, что многие из них предлагают готовые интеграции с мессенджерами и CRM. Перед выбором проверьте, где сервис хранит данные и как он выполняет требования 152-ФЗ.
Модели по API у российских поставщиков. API - программный интерфейс, через который ваш бот отправляет запросы модели. В Yandex AI Studio есть поисковые индексы Vector Store: по документации, их используют для поиска по файлам баз знаний, а среди примеров названы чат-боты для частых вопросов и внутренние базы знаний (документация). Там же есть инструмент File Search для поиска в файлах, который использует подход RAG (блог Yandex Cloud). В GigaChat API от Сбера есть метод для эмбеддингов - числовых представлений текста, которые, по документации, можно использовать в том числе для RAG (документация), и набор решений GigaChain для приложений на языковых моделях (GigaChain).
Модели зарубежных поставщиков. В посте я называл Gemini от Google, модели OpenAI и Claude от Anthropic. Каждый из этих сервисов официально в России не работает: России нет в списках стран, где доступны их API (Google, OpenAI, Anthropic). Для бота, который работает с клиентами в России, это ещё и вопрос персональных данных из раздела выше.
Открытые библиотеки. Для команды с разработчиками есть LangChain и LlamaIndex - библиотеки с открытым кодом под лицензией MIT, которая разрешает бесплатно использовать, изменять и распространять код (LangChain, LlamaIndex). С ними собирают всю цепочку RAG самостоятельно и подключают разные модели, в том числе открытую модель в собственной инфраструктуре. Если модель работает на вашем сервере, данные остаются у вас, но сервер, обновления и качество ответов становятся вашей заботой.
Подрядчик. Если своих разработчиков нет, бота собирает и настраивает интегратор. Расчёт и проверка из этой статьи пригодятся и здесь: просите показать долю верных ответов по вашим вопросам, а не демонстрацию на чужих примерах.
Где разместить бота, зависит от того, где пишут ваши клиенты: окно чата на сайте, мессенджер, почта. С Telegram в России сейчас есть ограничения: 10 февраля 2026 года Роскомнадзор подтвердил, что поэтапно ограничивает работу мессенджера (Business FM). На 11 октября 2026 года пользователи, по данным Hi-Tech Mail, продолжают сообщать о сбоях, чаще всего с загрузкой фото и видео; официальной информации о полной блокировке издание не приводит (Hi-Tech Mail). Поэтому для клиентов в России не делайте бота в Telegram единственным каналом: основной вход - чат сайта или другой канал, которым ваши клиенты пользуются.
Частые вопросы
Сколько вопросов бот сможет закрыть сам?
Заранее этого никто не скажет. По моей оценке в посте 2025 года, бот может справляться с 80% стандартных вопросов, но у вас доля зависит от полноты базы и того, насколько вопросы типовые. Измерьте её тестом из своих вопросов до покупки.
Нужно ли дообучать модель нашими документами?
Чтобы бот отвечал по вашим документам, дообучение не обязательно. При схеме RAG модель получает нужные фрагменты документов вместе с вопросом, а чтобы бот узнал новые условия, достаточно обновить документ в базе.
Может ли бот работать круглосуточно?
Да, бот отвечает в любое время, и это одна из причин его ставить. Но если ответа в базе нет, ночью клиента всё равно не с кем соединить: пусть бот сообщит, когда ответит специалист, и сохранит обращение, чтобы утром им занялся человек.
Можно ли положить в базу знаний переписку с клиентами?
Только после того, как из неё удалены персональные данные, и после согласования с юристом. Безопаснее собирать базу из инструкций, правил и обезличенных ответов на частые вопросы.
Сколько стоит такой бот?
Зависит от пути: подписка на конструктор, оплата модели за объём текста или разработка у подрядчика. Посчитайте окупаемость по формуле из статьи со своими числами, а цену запроса к модели - с помощью статьи о выборе нейросети.
Источники
Факты в статье проверены .
- Пост в канале @progress_on №83проверено
- Документация LlamaIndex: введение в RAGпроверено
- Lewis и др.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (arXiv, 2020)проверено
- NBER: Brynjolfsson, Li, Raymond. Generative AI at Work (w31161)проверено
- NBER Digest: Measuring the Productivity Impact of Generative AIпроверено
- Moffatt v. Air Canada, 2024 BCCRT 149: решение Civil Resolution Tribunalпроверено
- 152-ФЗ «О персональных данных», статья 3. Основные понятияпроверено
- 152-ФЗ «О персональных данных», статья 12. Трансграничная передачапроверено
- 152-ФЗ «О персональных данных», статья 16. Решения на основании автоматизированной обработкипроверено
- 152-ФЗ «О персональных данных», статья 18. Обязанности оператора при сборе данныхпроверено
- Портал персональных данных Роскомнадзора: трансграничная передачапроверено
- Документация Yandex AI Studio: поисковые индексы Vector Storeпроверено
- Блог Yandex Cloud: поиск по файлам File Search в AI Studio (18.03.2026)проверено
- Документация GigaChat API: эмбеддингипроверено
- GigaChain: решения для приложений на языковых моделяхпроверено
- LangChain на GitHub (лицензия MIT)проверено
- LlamaIndex на GitHub (лицензия MIT)проверено
- Google: страны, где доступен Gemini APIпроверено
- OpenAI: страны, где доступен APIпроверено
- Anthropic: страны и регионы, где доступны продуктыпроверено
- Business FM: в России официально замедлили Telegram (10.02.2026)проверено
- Hi-Tech Mail: что происходит с Telegram 11 октября 2026 годапроверено